我们使用机器学习技术将英文博客翻译为简体中文。您可以点击导航栏中的“中文(简体)”切换到英文版本。
如何评估合成数据的质量——从保真度、实用性和隐私的角度进行测量
在日益以数据为中心的世界中,企业必须专注于收集有价值的物理信息,并生成他们需要但不容易捕获的信息。数据访问、监管和合规性是分析和人工智能 (AI) 创新的越来越多的摩擦源。
对于金融服务、医疗保健、生命科学、汽车、机器人和制造业等监管严格的行业,问题甚至更大。它给系统设计、数据共享(内部和外部)、货币化、分析和机器学习(ML)造成障碍。
合成数据是一种解决许多数据挑战的工具,尤其是隐私保护、监管合规、可访问性、数据稀缺性和偏见等人工智能和分析问题。这还包括数据共享和数据发布时间(因此也包括上市时间)。
合成数据是通过算法生成的。它反映了源数据的统计属性和模式。但重要的是,它不包含敏感、私人或个人数据点。
你对合成数据提问,得到的答案与从真实数据中得到的答案相同。
在我们
对于业务利益相关者而言,要在机器学习和分析项目中采用合成数据,不仅要确保生成的合成数据符合目的和预期的下游应用程序,还必须确保他们能够测量和演示生成数据的质量。
随着保护隐私的法律和道德义务越来越多,合成数据的优势之一是能够在合成过程中删除敏感和原始信息。因此,除了质量外,我们还需要指标来评估私人信息泄露的风险(如果有),并评估生成过程没有 “记住” 或复制任何原始数据。
为了实现所有这些,我们可以将合成数据的质量映射到各个维度,这有助于用户、利益相关者和我们更好地理解生成的数据。
合成数据质量评估的三个维度
生成的合成数据是根据三个关键维度来衡量的:
- 富达
- 效用
- 隐私
以下是有关任何生成的合成数据的一些问题,应由合成数据质量报告来解答:
- 与原始训练集相比,这些合成数据有多相似?
- 这些合成数据对我们的下游应用程序有多大用处?
- 是否有任何信息从原始训练数据泄露到合成数据中?
- 我们的模型是否无意中合成了现实世界中被认为敏感的数据(来自未用于训练模型的其他数据集)?
为最终用户翻译这些维度的指标有些灵活。毕竟,要生成的数据在分布、大小和行为方面可能会有所不同。它们还应该易于理解和解释。
归根结底,指标必须完全由数据驱动,不需要任何先验知识或特定领域的信息。但是,如果用户想要应用适用于特定业务领域的特定规则和约束,则他们应该能够在综合过程中对其进行定义,以确保满足特定领域的保真度。
在以下各节中,我们将更详细地介绍这些指标。
了解保真度的指标
在任何数据科学项目中,我们必须了解特定的样本群体是否与我们正在解决的问题有关。同样,在评估生成的合成数据的相关性的过程中,我们必须根据与原始数据相比的
这些指标的可视化表现使其更易于理解。我们可以说明类别的基数和比率是否得到尊重,不同变量之间的相关性是否得到保留,等等。
可视化数据不仅有助于评估合成数据的质量,而且还适合作为数据科学生命周期的初始步骤之一,以便更好地理解数据。
让我们更详细地了解一些保真度指标。
探索性统计比较
在探索性统计比较中,使用关键统计指标探索原始数据集和合成数据集的特征,例如平均值、中位数、标准差、不同值、缺失值、最小值、最大值、连续要素的四分位数范围,以及每个类别的记录数、每个类别的缺失值以及类别属性出现次数最多的字符。
应在原始抵制数据集和合成数据之间进行比较。该评估将揭示比较的数据集在统计学上是否相似。如果不是,那么我们将了解哪些特征和衡量标准不同。如果发现存在显著差异,则应考虑使用不同的参数重新训练和重新生成合成数据。
该测试充当初步筛选,以确保合成数据对原始数据集具有合理的保真度,因此可以有效地进行更严格的测试。
直方图相似度分数
直方图相似度分数衡量合成数据集和原始数据集中每个特征的边际分布。
相似度分数介于零和一之间,分数为一表示合成数据分布与原始数据的分布完全重叠。
接近一的分数将使用户确信抵制数据集和合成数据集在统计学上是相似的。
相互信息分数
相互信息分数衡量两个特征(数字或分类特征)的相互依赖性,表示通过观察另一个特征可以从一个特征中获得多少信息。
相互信息可以测量非线性关系,使我们能够更全面地了解合成数据的质量,因为它可以让我们了解变量关系的保留程度。
分数为一表明合成数据完美地反映了特征之间的相互依赖性。
相关性分数
相关性分数用于衡量合成数据中原始数据集中的相关性的捕获情况。
两列或多列之间的相关性对于机器学习应用程序极为重要,这有助于发现特征与目标变量之间的关系,并有助于创建训练有素的模型。
相关性分数介于零和一之间,分数为一表示相关性已完全匹配。
与我们在数据问题中经常遇到的结构化表格数据不同,某些类型的结构化数据具有特定的行为,即过去的观测结果有可能影响下一个观测结果。这些数据被称为时间序列或顺序数据,例如,具有每小时室温测量值的数据集。
这种行为意味着需要定义某些指标来专门衡量这些时间序列数据集的质量
自相关和偏自相关分数
尽管与相关性类似,但自相关性显示了时间序列在当前值下与先前值的关系。消除先前的时间延迟的影响会产生部分自相关性。因此,自相关分数用于衡量合成数据从原始数据集中捕获显著自相关性或部分相关性的情况。
了解效用的指标
现在我们可能已经从统计学上意识到合成数据与原始数据集相似。此外,我们还必须评估在使用多种机器学习算法进行训练时,合成数据集在常见数据科学问题上的表现如何。
使用以下
预测分数
通过机器学习模型可以测量合成数据与原始真实数据相比的性能。下游模型分数通过比较在合成数据集和原始数据集上训练的机器学习模型的性能来衡量合成数据的质量。这分别提供
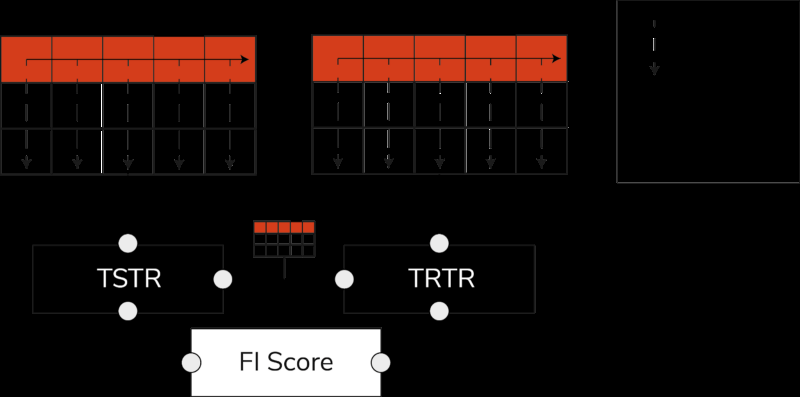
TSTR、TRTR 分数和功能重要性分数(图片由作者提供)
该分数包含用于回归或分类任务的各种最值得信赖的 ML 算法。使用多个分类器和回归器可确保分数在大多数算法中更具普遍性,因此合成数据将来可能会被视为有用。
最后,如果 TSTR 分数和 TRTR 分数相当,则表明合成数据具有用于训练适用于实际应用的有效机器学习模型的质量。
功能重要性分数
特征重要性 (FI) 分数与预测分数高度相关,通过增加TSTR和TRTR分数的可解释性来扩展预测分数。
F1 分数将获得的特征重要性顺序的变化和稳定性与预测分数进行比较。如果一组合成数据产生与原始真实数据相同的特征重要性顺序,则该数据集被认为具有很高的实用性。
qScore
为了确保根据我们新生成的数据进行训练的模型能够生成与使用原始数据训练的模型相同的问题答案,我们使用了 Qscore。这通过在合成数据集和原始(以及保持数据)数据集上运行许多基于随机聚合的查询来衡量合成数据的下游性能。
这里的想法是,这两个查询都应该返回相似的结果。
较高的 QScore 可确保使用查询和聚合操作的下游应用程序能够提供与原始数据集几乎相等的价值。
了解隐私的指标
在这些合成数据可以自由共享并用于下游应用程序之前,我们必须考虑隐私指标,这些指标可以帮助利益相关者了解生成的合成数据在泄露信息范围方面与原始数据相比所处的位置。此外,我们必须就如何共享和使用合成数据做出关键决定。
确切的比赛比分
对隐私的直接而直观的评估是在合成记录中寻找真实数据的副本。精确匹配分数计算在合成集合中可以找到的真实记录的数量。
分数应为零,表示合成数据中不存在真实信息。在我们评估进一步的隐私指标之前,该指标充当筛选机制。
邻居的隐私分数
此外,邻居的隐私分数衡量合成记录中可能与真实记录相似度过于接近的比例。这意味着,尽管它们不是直接副本,但它们是潜在的隐私泄露点,也是推理攻击的有用信息来源。
分数是通过对与原始数据重叠的合成数据进行高维近邻搜索来计算的。
成员资格推断分数
在数据科学生命周期中,模型一旦经过训练,就不再需要访问训练样本,可以对看不见的数据进行预测。同样,在我们的例子中,一旦合成器模型经过训练,就可以在不需要原始数据的情况下生成合成数据的样本。
通过一种称为
成员资格推理分数衡量成员资格推理攻击成功的可能性。
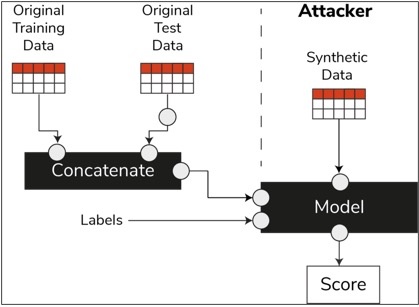
低分表明可以推断出特定记录是导致合成数据创建的训练数据集的成员。换句话说,攻击可以推断出个人记录的细节,从而损害隐私。
较高的成员资格推断分数表明攻击者不太可能确定特定记录是否是用于创建合成数据的原始数据集的一部分。这也意味着没有个人的信息通过合成数据受到损害。
Holdout 的概念
我们必须遵循的一个重要最佳做法是确保合成数据足够通用,不会过度拟合训练时所依据的原始数据。在典型的数据科学流程中,在构建 ML 模型(例如随机森林分类器)时,我们会预留测试数据,使用训练数据训练模型,并根据看不见的测试数据评估指标。
同样,对于合成数据,我们会保留原始数据的样本(通常称为抵制数据集或看不见的隐瞒测试数据),并根据抵制数据集评估生成的合成数据。
Holdout 数据集预计将代表原始数据,但在生成合成数据时尚未显示。因此,在将原始数据集与抵制数据集和合成数据集进行比较时,所有指标的分数都相似至关重要。
当获得相似的分数时,我们可以确定合成数据点不是记住原始数据点的结果,同时保持相同的保真度和实用性。
最后的想法
世界开始理解合成数据的战略重要性。作为数据科学家和数据生成者,我们有责任建立对我们生成的合成数据的信任,并确保其有用途。
合成数据正在发展成为数据科学开发工具包中的必备工具。《麻省理工学院技术评论》
根据
合成数据的生成是为了了解下游应用程序,并了解合成数据质量的不同维度之间的权衡。
摘要
作为合成数据的用户,必须定义将来将要使用的每个合成样本的用例背景。与真实数据一样,合成数据的质量取决于预期的用例以及为合成选择的参数。
例如,在合成数据中像在原始数据中一样保留异常值对于欺诈检测用例很有用。但是,它在有隐私问题的医疗用例中没有用,因为异常值通常可能是信息泄露。
此外,在忠诚度、实用性和隐私之间存在权衡取舍。无法同时针对所有三种数据进行优化。这些指标使利益相关者能够优先考虑每个用例必不可少的内容,并管理生成的合成数据中的预期。
最终,当我们看到每个指标的价值以及它们达到预期时,利益相关者可以对他们使用合成数据构建的解决方案充满信心。
结构化合成数据的用例涵盖了从用于软件开发的测试数据到在临床试验中创建合成控制臂的广泛应用。
伸出援手探索这些机会或建立 PoC 来展示价值。
*前述特定亚马逊云科技生成式人工智能相关的服务仅在亚马逊云科技海外区域可用,亚马逊云科技中国仅为帮助您发展海外业务和/或了解行业前沿技术选择推荐该服务。